MLF Lecture 2 Perceptron Learning Algorithm
機器學習基石(Machine Learning Foundations)笔记第一弹
PLA 定义
用来解决线性可划分问题。 通过比较给定数据向量 X 与其权重向量 W 的加权和 $\sum_{i=1}^d{w_ix_i}$ 与给定的阀值 therhold,决定是否同意某事(Y=1 or Y=-1) 即,$h(x)=sign(\sum_{i=1}^d{w_{i}x_i} - threshold)$ 将上式中的(-threshold)看做 w0 ,附上(+1)的因子 x0 ,进一步变化:
其中 WTX 为两个一维向量的内积。
PLA 过程
以二维向量为例,可以将h(x) = sign(w0 + w1x1 + w2x2)括号内的部分看做一条关于 x 的直线。对每一个数据点(x1, x2, …, xn),不断修正当前直线的位置,直到所有点都满足 h(x)=yn(t)
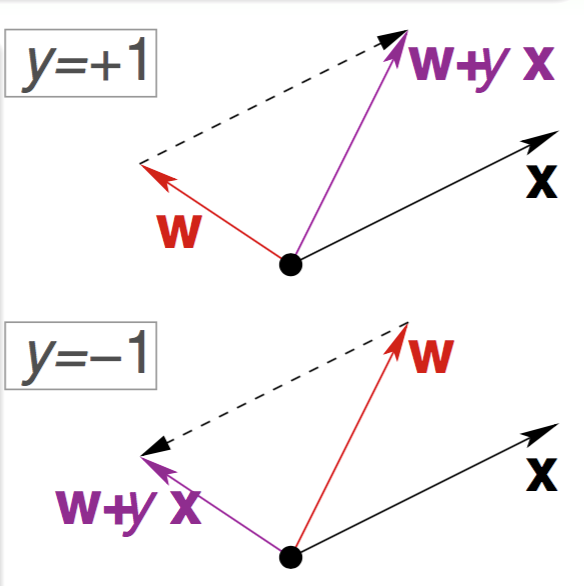
解释
- y = +1 时,W⃗ ⋅ X⃗ < 0,需要减少W⃗与X⃗的夹角
- y = -1 时,W⃗ ⋅ X⃗ > 0,需要增大W⃗与X⃗的夹角
算法
For t = 0, 1, …
find a mistake of Wt called (xn(t), yn(t))
(try to) correct the mistake by
… until no more mistakes
return last w (called WPLA) as g
PLA 运行次数上限证明
仅当给定数据集线性可分时 PLA,PLA 可收敛。
线性可分(Linear Separability)
- if PLA halts (i.e
no more mistakes),
(necessary condition) D allows some w to make no mistake - call such D linear separable
此时,可以假设存在我们需要的那个函数代表的向量Wf满足:
证明铺垫 1
可以看出,当前向量 Wt 不断向理想向量 Wf 接近,因为两者的内积不断增大(但内积增大可能是由于向量长度的变化) wfTwt↑ by updating with any (xn(t), yn(t))
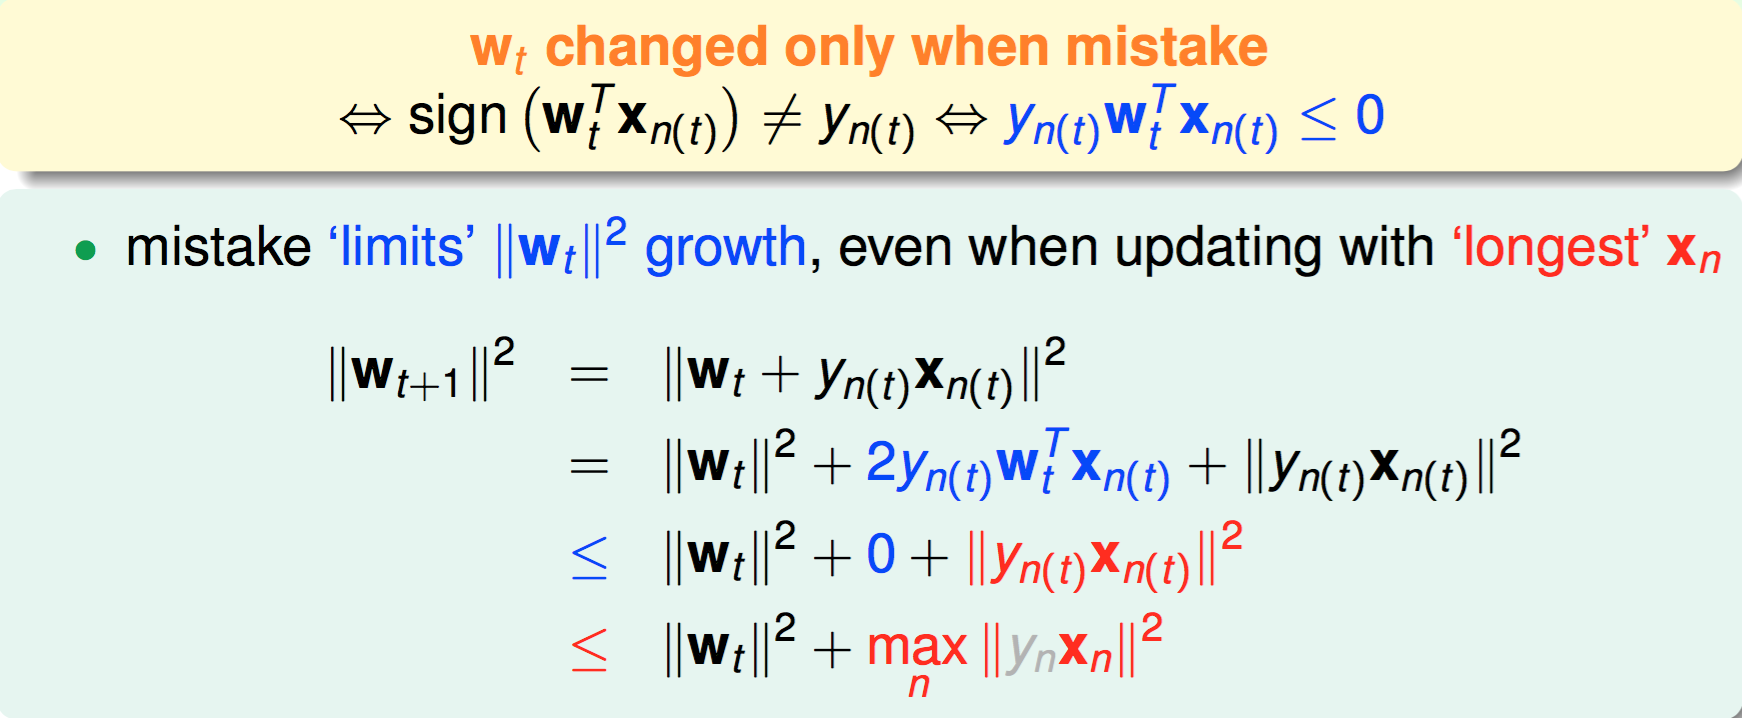
证明铺垫 2
Wt 的模的增长速度受导致每个修正的错误点的限制 (wt changed only when mistake)
证明运行次数 T 的上限
先定义$R^2=\mathop{max}\limits_{n}||x_n||^2$ $\rho = \mathop{min}\limits_n y_n \dfrac{W_f^T}{||W_f||}X_n$
由证明步骤 1 中结论:
由证明步骤 2 中结论:
用 R 和ρ 对以上两条不等式进行代换可得:
再由两个单位向量的内积 < 1,得到
算法收敛性得证
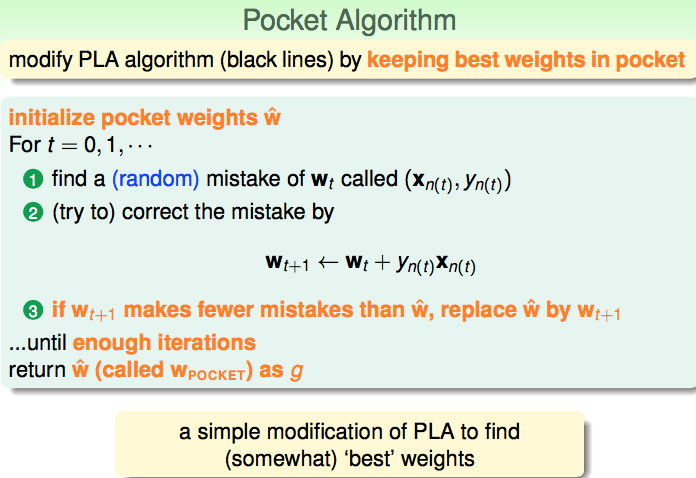
Pocket Algorithm
对 PLA 稍加改造:遍历结束时返回当前最优 Wt
用来应对无法确定 PLA 上界的问题。但由于每次更新 Wt 都要检查 Wt+1和 Wt 对所有点的正确数,所以相对 PLA 花费额外时间。